
AI 点子让一篇故事更受好评,也可能让整组故事更相像
本文目录
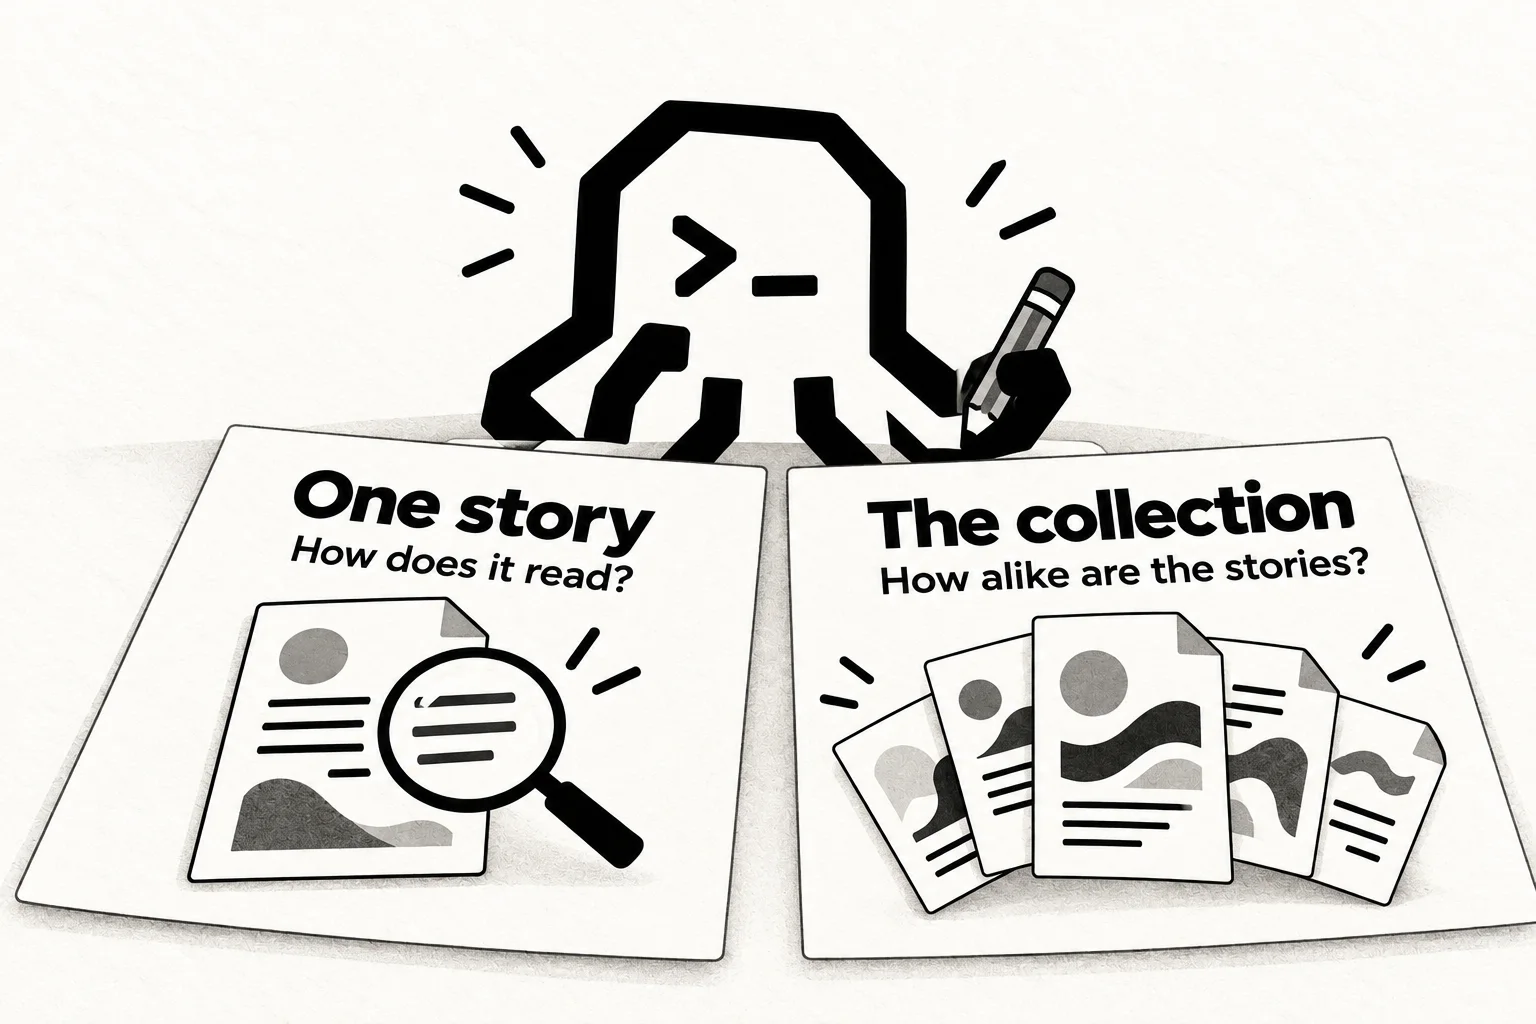
故事可以更受好评,同时也更像同组的其他作品。
一组作品,逐篇读都不错,放在一起却总像在讲同一件事。用 AI 想点子时,这项区别值得留意:一篇作品表现得怎样,与一组作品提供了多少差异,是两个问题。 前者得分更高,并不能替后者作答。
Anil R. Doshi 和 Oliver P. Hauser 在 2024 年的一项研究中发现,获得 AI 点子支持的写作者,其故事平均得到更高评价,同时故事之间也更相似。这两项发现并不矛盾,用的是不同尺度。
单篇故事,在读者看来怎样?
这项预注册在线实验的最终样本包括 293 名英国参与者,并非职业作家样本。他们围绕随机分配的三个冒险主题之一,写八句英文故事:海上、丛林或另一个星球。
写作者被随机分到三种条件:不提供 AI 点子、可以请求一个 GPT-4 点子,或可以请求最多五个。每个 AI 点子是三句故事起点,完整故事由人写,不是请 GPT-4 代写全文。“最多五个”是可用选项,不代表每个人实际都请求了五个。
另一组 600 名读者,先在未获知写作者是否使用 AI 的情况下评价故事。这是初次评价阶段;之后研究才披露 AI 使用信息,用于其他问题。
读者评价包括新颖性与适用性。新颖性关注故事是否显得原创、少见;这里的适用性则涉及目标读者是否合适,以及能否发展成可出版的书。这些是读者判断,并非实际出版结果。
平均而言,两个可获得 AI 点子的条件,其新颖性与适用性评价都高于无 AI 条件,最多五个点子的条件提升更大。这说明单篇故事怎样被接受,还没有回答这些故事彼此有多不同。
放在一起,故事之间又有多大差异?
为回答这个问题,研究者使用文本嵌入,也就是故事的数值表示。他们计算每篇故事的嵌入,与同一实验条件下其余故事平均嵌入之间的余弦相似度。两个可获得 AI 点子的条件,其故事都比无 AI 条件更接近各自组内的平均表示。
这衡量的是这些文本表示中的相似程度,不是逐字重复率,也不等于衡量整个社会的创意多样性。一篇故事可以让读者觉得不错,同时在另一项尺度上更靠近同组作品。
| 问题 | 研究怎样衡量 |
|---|---|
| 这篇故事是否显得新颖、适用? | 读者对单篇作品的评价。 |
| 这篇故事与同组其他故事有多相似? | 它的嵌入与同组其余故事平均嵌入的相似度。 |
作者以对 AI 点子的锚定来解释现象。但实验没有比较先独立构思与先问 AI,也没有单独识别相似度背后的所有认知机制。它研究的是当时 GPT-4 条件下受约束的短故事,不能直接外推到所有创作任务或 2026 年的模型。
用这项区别读一遍已有选题
一个编辑上的用法,是打开手头已有的选题清单,把它们当作一组来读。先越过标题,看几个候选是否其实在回答同一个问题、采用同一种观察角度。措辞变好,能让每个候选更吸引人,却未必增加一个值得保留它的理由。
挑出一项你能解释的实质差异。也许某个候选回应了读者另一项决定,也许你已有的工作观察或阅读材料,能支持对问题另一面的讨论。因为这项区别对目标读者有用而保留它。如果确有相关观察或材料,就把它们带进请求,不让 AI 替你虚构亲历。
接下来,请 AI 帮你表达已选定的区别:
请帮我说明,这个选题为什么值得与其他候选并列。使用我提供的不同问题与支持材料,不要又写成同一角度的另一个版本,也不要添加我没有提供的经历。
有用的成果是一个保留该候选的理由,而不是更长的生成清单。这是编辑建议,不是 Doshi 与 Hauser 实验验证过的干预,也不保证多样性。该研究同样不能证明,先自己想、换角色或多开聊天就能保住差异。
差异还需要服务具体目的。一组标准通知,可能本来就应该一致;一组原本要覆盖不同问题的文章,则值得在逐篇看质量之外,再单独看它们是否过于相像。